
Wer nach API-Integration Mittelstand sucht, erwartet eine schnelle Antwort: eine fertige Schnittstelle, die zwei Systeme verbindet, und das war’s. Für einfache Datenflüsse – etwa eine Adresse hier, eine Bestellung dort als vereinfachtes Beispiel – funktioniert das zuverlässig. Bei komplexen Geschäftsprozessen mit mehreren Systemen, Partnern und Ausnahmeregeln stößt dieses Modell jedoch an eine Grenze, die sich nicht durch ein weiteres Plugin oder eine neue API-Version beheben lässt. Der folgende Beitrag zeigt, woran das liegt, mit welcher Prüfreihenfolge sich das Problem einordnen lässt und wann eine maßgeschneiderte Integrationsarchitektur den Mehraufwand tatsächlich rechtfertigt.
Warum Standard-Schnittstellen bei komplexen Prozessen kippen
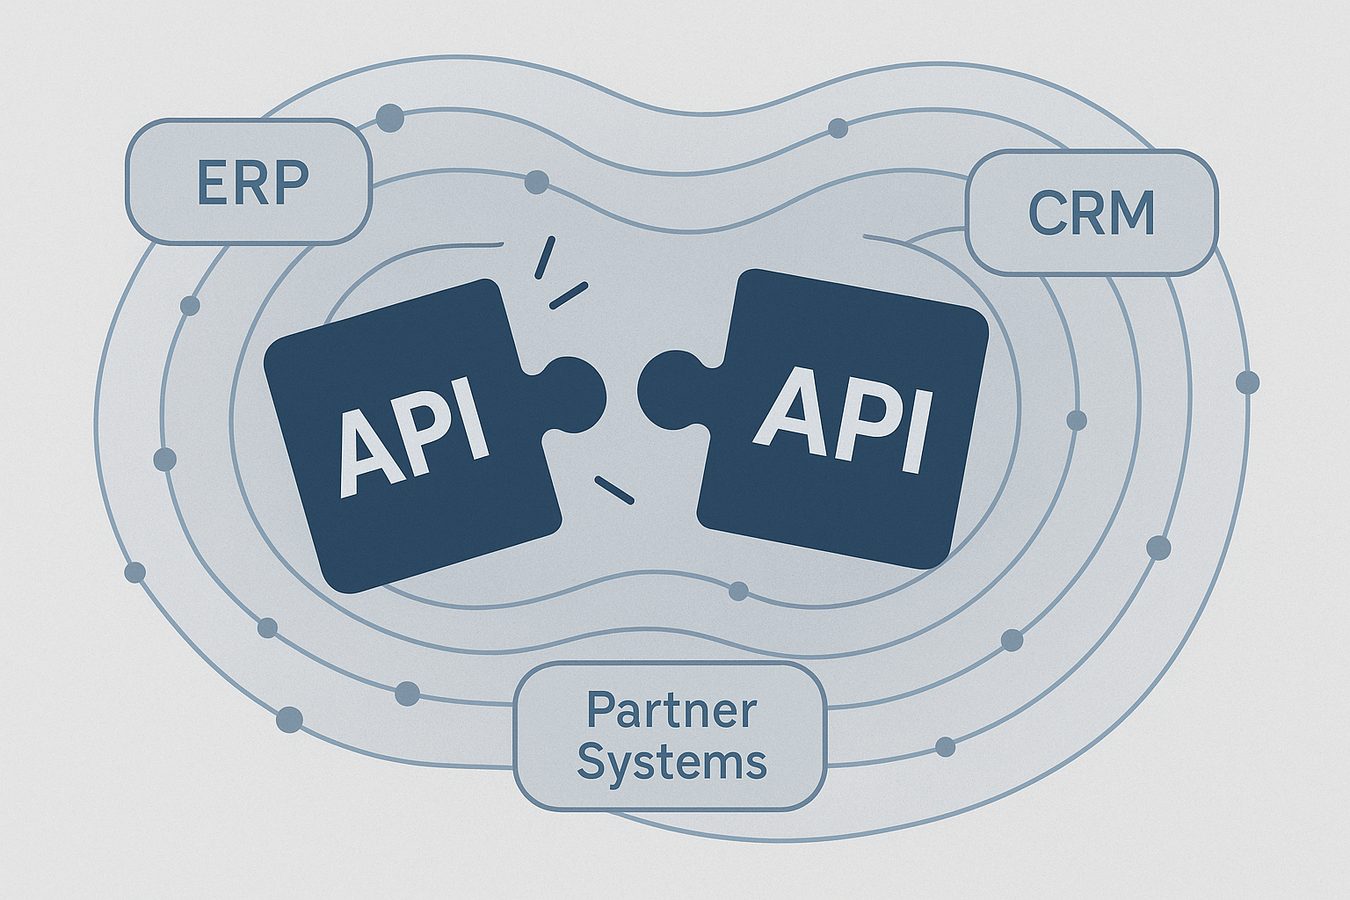
Klassische Punkt-zu-Punkt-APIs verbinden zwei Systeme direkt: System A ruft eine Schnittstelle von System B auf, die Daten fließen in einem festen Format. Das funktioniert, solange es bei wenigen Verbindungen bleibt. Sobald jedoch mehrere Systeme oder Partner eingebunden werden müssen, wächst der Aufwand mit jeder neuen Verbindung, weil jede einzeln entwickelt, getestet und gepflegt werden muss – diesen Zusammenhang zwischen Systemanzahl und Integrationsaufwand beschreibt etwa bigdata-insider.de. Ein vereinfachtes Beispiel verdeutlicht die Konsequenz: Baut ein Unternehmen für jeden neuen Vertriebspartner zunächst eine eigene 1:1-Schnittstelle, steigen Komplexität und Pflegeaufwand mit der Zahl der Partner. Eine in System-, Process- und Experience-API-Schichten organisierte Architektur wird als ein Ansatz beschrieben, um solche einzelnen Punkt-zu-Punkt-Verbindungen durch eine wiederverwendbare Struktur abzulösen (it-daily.net). Ereignisgesteuerte Architekturen und iPaaS-Plattformen werden in einer Übersicht von it-daily.net als Alternativen genannt, wenn klassische APIs bei komplexen Abhängigkeiten an ihre Grenzen stoßen und zu starker Kopplung der Systeme führen (it-daily.net).
Das Kontextproblem: Was eine Standard-Spezifikation nicht transportieren kann
Ein zweiter Grund liegt tiefer als die reine Verbindungsanzahl. Im Interview mit Erik Wilde wird beschrieben, dass Standard-Schnittstellenbeschreibungen wie OpenAPI-Spezifikationen zwar Endpunkte, Parameter und Datentypen dokumentieren, aber nicht das Wissen transportieren, das ein Entwickler mitbringt, wenn er eine Schnittstelle in einen Geschäftsprozess einbaut: welche Reihenfolge von Aufrufen zulässig ist, welche Ausnahme in welchem Fall gilt, welche Felder nur in bestimmten Konstellationen Pflicht sind. Nach dieser Einschätzung reicht bei komplexeren Schnittstellen eine automatisch aus OpenAPI generierte Beschreibung nicht aus, weil Standardspezifikationen implizites Kontextwissen voraussetzen, das bislang nur Menschen in die Integration eingebracht haben (heise.de). Ein ähnliches Muster zeigt sich bei starren herstellerspezifischen Datenformaten: Nach einem Praxisbericht kann ein individuell entwickeltes, generisches API-Konzept ein festes Datenformat durch ein flexibleres, selbst modelliertes Datenmodell ersetzen, wenn das vorgegebene Format die eigene Prozesslogik nicht abbilden kann (it-daily.net).
Eine Prüfreihenfolge, bevor Sie eine individuelle Integration bauen
Nicht jedes Integrationsproblem braucht eine maßgeschneiderte Lösung. Die folgende Reihenfolge hilft, vor der Technologieentscheidung zu klären, ob eine Standard-API ausreicht oder ob der Aufwand einer individuellen Architektur gerechtfertigt ist. Sie ist redaktionell aus den oben beschriebenen Mechanismen abgeleitet, kein in einer Studie validiertes Modell:
- Anzahl und Wachstum der Verbindungen: Werden aktuell oder absehbar mehrere Systeme oder Partner angebunden, wächst der Punkt-zu-Punkt-Aufwand mit jeder weiteren Verbindung – ein Hinweis auf den Bedarf einer entkoppelnden Middleware-Schicht.
- Format-Starrheit: Gibt die Standardschnittstelle ein festes, herstellerspezifisches Datenformat vor, das die eigene Prozesslogik nicht abbildet, kann ein flexibleres, individuell modelliertes Datenformat eine Lösung sein – so beschreibt es ein Praxisbericht für einen konkreten Fall.
- Kontextbedarf: Muss bei jedem Aufruf Wissen über Ausnahmen, Reihenfolgen oder Geschäftsregeln mitgedacht werden, das in der Standard-Spezifikation nicht steht, wandert dieses Wissen entweder in die Köpfe der Entwickler – oder es wird explizit in einer eigenen Integrationsschicht codiert.
- Heterogenität der Quellsysteme: Arbeiten die anzubindenden Systeme mit unterschiedlichen Protokollen und kaum standardisierten Schnittstellen, lässt sich das nicht über eine einzelne Standard-API lösen – hier verschärfen sich die beiden oben beschriebenen Probleme, Verbindungsanzahl und Formatstarrheit, gegenseitig.
Quelle zu diesen Punkten: Mit den richtigen Schnittstellen IT-Projekte beschleunigen (it-daily.net).
Architekturoptionen im Vergleich
Fällt die Prüfung zugunsten einer individuellen Lösung aus, stehen unterschiedliche Architekturmuster zur Wahl – mit unterschiedlichem Aufwand und unterschiedlicher Flexibilität:
- Punkt-zu-Punkt-API: schnell umgesetzt, geringer Initialaufwand, aber der Pflegeaufwand wächst mit jeder weiteren Verbindung – geeignet bei wenigen, stabilen Verbindungen.
- Middleware- beziehungsweise iPaaS-Schicht: entkoppelt Quell- und Zielsysteme und reduziert den Aufwand bei wachsender Systemlandschaft, erfordert aber eine zusätzliche Betriebsebene mit eigenem Pflegeaufwand.
- Geschichtete Individual-API nach System-, Process- und Experience-Ebene: bildet Geschäftslogik unabhängig von den Quellsystemen ab und bleibt bei neuen Partnern erweiterbar, verlangt aber beim Aufbau mehr Entwicklungsaufwand und Fachwissen als eine fertige Standard-API.
Quellen zu diesen Punkten: Integration: Entscheidender Faktor für mehr Wettbewerbsfähigkeit (bigdata-insider.de), APIs, iPaaS und ereignisgesteuerte Architekturen im Überblick und Mit API raus aus dem Schnittstellen-Dschungel (beide it-daily.net).
Was die individuelle Lösung kostet – und wann der einfache Weg reicht
Eine maßgeschneiderte Integrationsarchitektur ist kein Selbstzweck. Die Entwicklung eines generischen, individuellen API-Konzepts erfordert nach einem Praxisbericht erhebliche Ressourcen und Fachwissen, die in diesem Fall intern fehlten – das ist der Preis für die gewonnene Flexibilität (it-daily.net). Das bedeutet nicht, dass jede Standard-API ersetzt werden muss. Wenn die Systemlandschaft klein und stabil bleibt, keine neuen Partner oder Formate absehbar sind und die vorhandene Schnittstelle die Prozesslogik bereits abbildet, ist der Pflegeaufwand einer zusätzlichen Integrationsschicht nicht gerechtfertigt.
Nächster Schritt: Bestandsaufnahme statt Architekturdiskussion
Wer bei der Prüfreihenfolge weiter oben mehrfach auf individuellen Anpassungsbedarf stößt, sollte nicht bei der nächsten API-Version ansetzen, sondern bei der dahinterliegenden Architektur. Das muss kein kompletter Umbau sein: Bestehende Schnittstellen lassen sich schrittweise ablösen, wie der Beitrag zur Legacy-Modernisierung ohne Big Bang beschreibt. Wo die Heterogenität nicht bei Partnern, sondern zwischen ERP, MES und Maschinendaten in der Fertigung liegt, zeigt der Beitrag zur Datensilo-Auflösung in der Fertigung eine mögliche Integrationsstrategie. Ein erster konkreter Schritt ist eine Bestandsaufnahme: Welche Schnittstellen bestehen heute, welche davon wurden zuletzt mehrfach angepasst oder durch Workarounds umgangen, und wo wächst die Zahl der angebundenen Partner oder Systeme spürbar? Diese Liste zeigt meist schneller als jede Architekturdiskussion, wo eine individuelle Integrationslösung ansetzen sollte. Für den Übergang von starren Altstrukturen zu einer flexiblen, individuell kontrollierten Architektur bietet die Leistungsseite Legacy-Modernisierung einen Ausgangspunkt.
Häufige Fragen
Eine Middleware entkoppelt Quell- und Zielsysteme und reduziert den Pflegeaufwand bei wachsender Systemlandschaft (bigdata-insider.de). Redaktionell lässt sich daraus ableiten, dass sie die Modellierung der Prozesslogik selbst nicht ersetzt: Bleibt diese aus, verschiebt sich das Kopplungsproblem lediglich von den Endsystemen in die Middleware.
Ja. Im Interview mit Erik Wilde wird beschrieben, dass automatisch generierte OpenAPI-Beschreibungen bei komplexeren Schnittstellen nicht ausreichen, weil sie implizites Kontextwissen voraussetzen, das bislang menschliche Entwickler mitbrachten. Wird eine Schnittstelle künftig auch von KI-Systemen angesprochen, muss dieses Wissen expliziter dokumentiert oder in die API-Struktur eingebaut werden.
Der beschriebene Mechanismus zeigt: Der Pflegeaufwand einer Punkt-zu-Punkt-API wächst mit der Anzahl der angebundenen Systeme (bigdata-insider.de). Bei nur ein bis zwei stabilen Verbindungen bleibt dieser Aufwand entsprechend begrenzt. Redaktionell lässt sich daraus ableiten, dass sich eine individuelle Architektur erst dann lohnt, wenn absehbar weitere Systeme, Partner oder Formate hinzukommen.
Ein Integrationsproblem zeigt sich daran, dass Daten strukturell nicht zwischen Systemen fließen oder Prozesslogik nicht abgebildet werden kann. Ein Datenqualitätsproblem besteht dagegen auch bei funktionierender Schnittstelle fort, weil die Daten selbst unvollständig oder fehlerhaft sind. Eine Einordnung dieser Unterscheidung liefert der Beitrag Garbage In, Garbage Out.
Transparenzhinweis: Bei der Erstellung dieses Beitrags wurde generative KI unterstützend eingesetzt. Inhalt, Faktenprüfung und finale Redaktion erfolgten durch Ancud