„Garbage in, garbage out“ ist keine neue Weisheit, trifft aber den Kern dessen, woran viele Analytics- und KI-Vorhaben im Mittelstand scheitern – lange bevor ein Modell trainiert oder ein Dashboard gebaut wird. Laut it-daily.net kämpft der Mittelstand vor allem mit mangelhafter Datenqualität und der Zusammenführung heterogener Datenquellen (it-daily.net). Das Problem liegt damit selten im gewählten Tool, sondern in der Datenbasis, auf der es arbeitet. Dieser Beitrag erklärt den Mechanismus dahinter, zeigt eine Prüfreihenfolge, mit der sich echte Datenqualitätsprobleme von reinen Integrationsproblemen unterscheiden lassen, und benennt, wann zentrale und wann dezentrale Maßnahmen greifen.
Warum Datenqualität im Mittelstand zum Flaschenhals wird
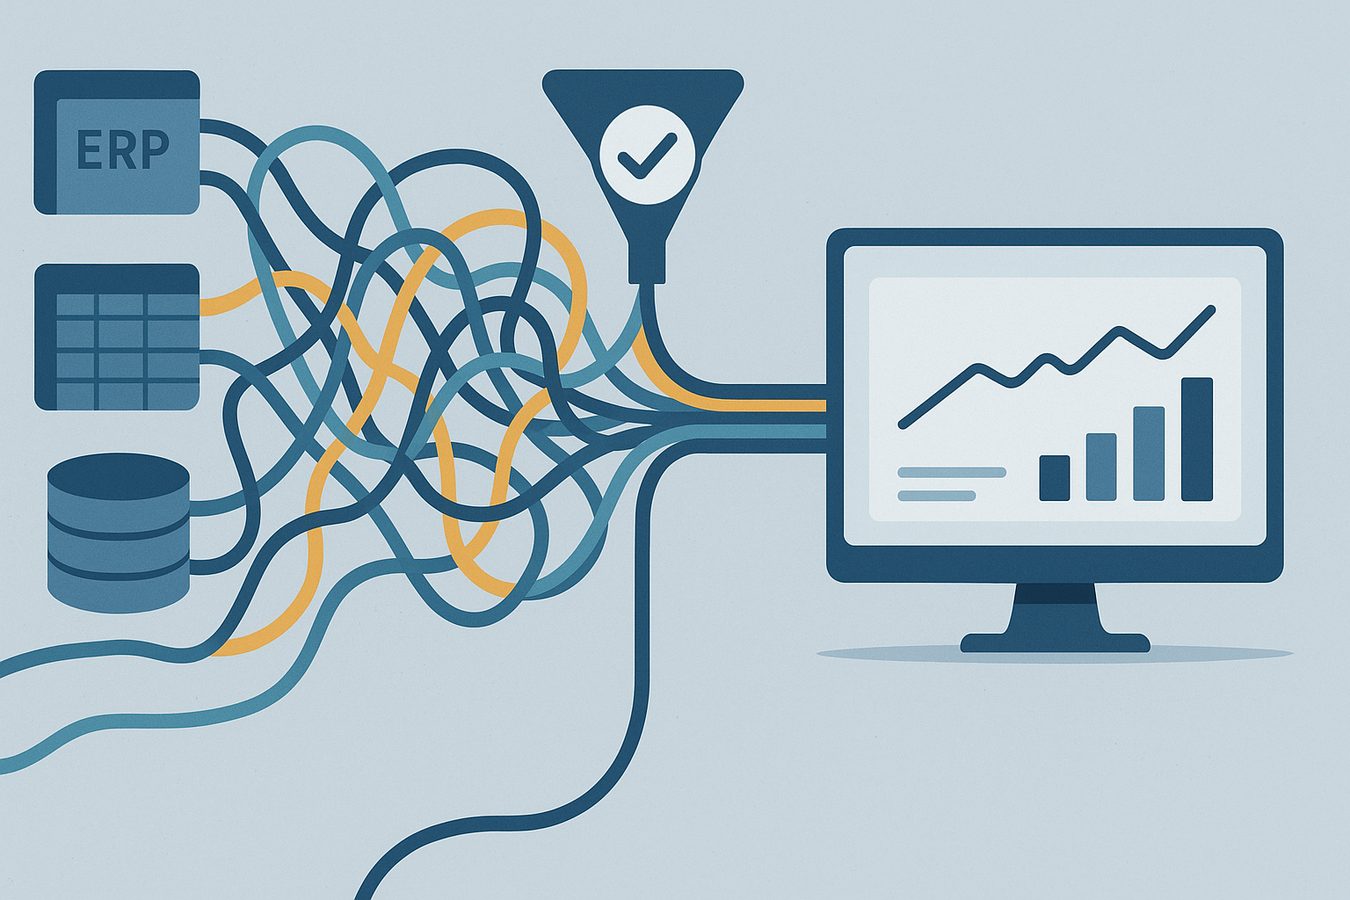
Ein in der Praxis häufig beschriebenes Muster: Datenbestände wachsen über Jahre in getrennten Systemen – ERP für Materialstammdaten, CRM für Kundendaten, Fachabteilungslösungen und Excel-Listen für alles dazwischen. Jede Abteilung pflegt ihre Daten nach eigener Logik und für den eigenen operativen Zweck – ein Produktionsleiter benötigt beispielsweise andere Feldinhalte als ein Einkäufer. Ein Beitrag auf produktion.de beschreibt das am Beispiel von Materialstammdaten: Wenn Konstruktion und Einkauf getrennt voneinander pflegen, entstehen Dubletten und inkonsistente Bezeichnungen für dasselbe Bauteil (produktion.de). Solange diese Daten nur innerhalb ihres Ursprungssystems genutzt werden, fallen solche Inkonsistenzen kaum auf. Erst wenn Analytics oder ein KI-Modell Daten über Systemgrenzen hinweg zusammenführt und aggregiert, werden sie sichtbar – allerdings meist erst als falsches Ergebnis, nicht als erkennbarer Fehler in der Eingabemaske. Ein it-daily.net-Beitrag zum SAP-Umfeld beschreibt in diesem Zusammenhang ein Beispiel, in dem ein KI-Vorhaben nicht an der Modellwahl, sondern an mangelhafter Datenqualität und fehlender Integration in bestehende Systeme scheiterte (it-daily.net).
Datenqualität entsteht nicht im Analytics-Tool, sondern an der Stelle, an der die Daten erzeugt werden.
Was schlechte Daten tatsächlich kosten – und was sich nicht belegen lässt
Auch laut industry-of-things.de scheitern KI-Projekte seltener an der Technologie selbst als an mangelnder Datenqualität, fehlenden technischen Voraussetzungen und organisatorischen Faktoren (industry-of-things.de). Laut einer Untersuchung auf bigdata-insider.de zählt zu geringe Datenqualität zu den größten Hindernissen bei der Datenauswertung im Mittelstand (bigdata-insider.de). Laut it-daily.net verursacht schlechte Datenqualität in Unternehmen erhebliche, aber kaum verlässlich bezifferbare jährliche Kosten (it-daily.net); belastbare, auf deutsche Mittelständler übertragbare Kostenzahlen liegen nicht vor.
Diagnostische Reihenfolge: Wo ansetzen, bevor Tools gekauft werden
Wer auf ein Datenqualitätsproblem sofort mit einem neuen Tool reagiert, behandelt oft nur das Symptom. Sinnvoller ist eine Prüfreihenfolge, die vor der Toolauswahl klärt, woran es wirklich hakt:
- Verwendungszweck klären: Ist nicht definiert, wofür die Daten später genutzt werden, lassen sich Qualitätsanforderungen gar nicht festlegen – ohne bekannten Verwendungszweck sind darauf aufbauende Entscheidungen kaum belastbar (it-daily.net).
- Dateneigentümer identifizieren: wer pflegt welches Feld, in welchem System, nach welcher Logik.
- Relevante Fehlerarten für den konkreten Anwendungsfall bestimmen: nicht jede Unsauberkeit wirkt sich auf jedes Analytics-Ergebnis gleich aus.
- Technische Zusammenführbarkeit prüfen: Lassen sich die Quellsysteme überhaupt konsistent verknüpfen, oder scheitert es schon an Schnittstellen und Formaten – laut it-daily.net ein verbreitetes Problem im Mittelstand (it-daily.net).
- Erst danach Cleansing-Maßnahmen und Tools bewerten: Laut it-daily.net setzen Unternehmen dabei vor allem auf Dublettenabgleich, Prüfung auf postalische Richtigkeit und E-Mail-Validierung (it-daily.net).
Diese Reihenfolge liefert zugleich das Unterscheidungskriterium zwischen den beiden Problemtypen: Scheitert die Zusammenführung bereits an Formaten oder Schnittstellen, liegt ein Integrationsproblem vor. Bleiben Werte auch nach technisch gelungener Zusammenführung inhaltlich falsch oder widersprüchlich, liegt ein Datenqualitätsproblem vor.
Zentrales Data-Quality-Gate oder dezentrale Verantwortung?
Für die Umsetzung bleiben im Kern zwei Wege, die sich nicht gegenseitig ausschließen, aber unterschiedliche Stärken haben:
- Zentrales Data-Quality-Gate vor der Analytics-Schicht: schafft einheitliche Regeln über alle Quellsysteme hinweg, ist aber von fachlichem Kontext entkoppelt und reagiert tendenziell auf Symptome statt auf Ursachen.
- Dezentrale Verantwortung in den Fachabteilungen: Ein Beitrag auf produktion.de empfiehlt als ersten Schritt klare Zuständigkeiten für Dateneingabe und Fehlerbereinigung direkt dort, wo Daten entstehen (produktion.de) – das vermeidet Fehler an der Quelle, erfordert aber Abstimmung zwischen Abteilungen und führt ohne übergreifende Regeln zu uneinheitlichen Standards.
Welcher Weg trägt, hängt im Kern von zwei Kriterien ab: der Anzahl und Heterogenität der Quellsysteme und der Entscheidungsrelevanz der betroffenen Daten. Als Faustregel gilt: Bei wenigen, klar abgegrenzten Systemen und überwiegend deskriptiver Nutzung kann die dezentrale Zuständigkeit mit abgestimmten Pflegeregeln ausreichen. Sobald jedoch mehrere Systeme dieselben Objekte unterschiedlich beschreiben – ein konstruiertes Beispiel wäre das Zusammenspiel von ERP, MES und IoT-Systemen in der Fertigung – oder die Daten in finanzielle beziehungsweise operative Entscheidungen einfließen, braucht es zusätzlich eine zentrale Schicht, die Konsistenz über Systemgrenzen herstellt (siehe dazu: Datensilo-Auflösung in der Fertigung).
Wann sich der Aufwand lohnt – und wann ein einfacherer Weg reicht
Nicht jedes Analytics-Vorhaben rechtfertigt ein systematisches Data-Quality-Programm. Für explorative Auswertungen mit geringer Entscheidungsrelevanz reichen oft Stichproben und eine kurze Plausibilitätsprüfung der wichtigsten Felder. Sobald Ergebnisse jedoch in Preisentscheidungen, Lieferketten- oder Kapazitätsplanung einfließen, wiegt ein Fehler in der Datenbasis entsprechend schwerer – hier trägt der systematische Ansatz mit klaren Zuständigkeiten und, falls nötig, zentralem Gate. Wie bei anderen gewachsenen IT-Landschaften gilt auch hier: Datenqualität lässt sich modulweise verbessern, parallel zum laufenden Betrieb, statt in einem einmaligen Großprojekt (siehe Legacy-Modernisierung ohne Big Bang).
Der konkrete erste Schritt vor dem nächsten Analytics- oder KI-Projekt ist deshalb nicht die Tool-Auswahl, sondern die schriftliche Beantwortung der Fragen aus der Prüfreihenfolge: Wofür sollen die Daten verwendet werden, wer ist für welches Feld verantwortlich, und wo brechen die Systeme auseinander? Eine kurze Liste der benötigten Felder mit den jeweils zuständigen Personen je System ist dafür ein praktikabler Ausgangspunkt. Wer diese Grundlage klärt, bevor er in Datenanalyse mit Machine Learning investiert, vermeidet, dass das Projekt an derselben Stelle scheitert wie viele vor ihm.
Häufige Fragen
Ein Tool kann Dubletten erkennen oder Formate validieren, löst aber nicht die organisatorische Ursache: unterschiedliche Pflegeprozesse in den Fachabteilungen. Ohne geklärte Zuständigkeiten entstehen bereinigte Fehler beim nächsten Dateneingabezyklus erneut.
Datenqualität beschreibt den Zustand der Daten selbst – korrekt, vollständig, konsistent. Data Governance umfasst die Regeln, Rollen und Prozesse, die diesen Zustand dauerhaft sichern sollen. Datenqualitätsmaßnahmen ohne Governance bleiben Einmalaktionen, weil niemand für den Zustand nach der Bereinigung verantwortlich ist.
Nein, sinnvoller ist eine Priorisierung nach Entscheidungsrelevanz der Daten. Felder, die in finanzielle oder operative Entscheidungen einfließen, werden zuerst geprüft; rein deskriptive Auswertungen vertragen eine deutlich geringere Fehlerquote.
Beide Rollen sind nötig, aber für unterschiedliche Aufgaben. Fachabteilungen kennen die fachliche Bedeutung eines Feldes und erkennen Eingabefehler am ehesten, die IT stellt die technische Infrastruktur für Validierung und systemübergreifende Zusammenführung bereit. Fehlt eine der beiden Seiten, bleibt entweder die fachliche Richtigkeit oder die technische Konsistenz auf der Strecke.
Transparenzhinweis: Bei der Erstellung dieses Beitrags wurde generative KI unterstützend eingesetzt. Inhalt, Faktenprüfung und finale Redaktion erfolgten durch Ancud