
Ad-hoc-Datenanalyse per natürlicher Sprache
Ad-hoc-Datenanalyse per natürlicher Sprache erlaubt Ihren Fachbereichen, Fragen wie „Wie hat sich die Marge in Region Süd entwickelt?“ direkt zu stellen und Auswertung samt Visualisierung aus geprüften Unternehmensdaten zu erhalten.
- Fragen in Alltagssprache statt Ticket an das Berichtswesen
- Antworten aus Ihrer bestehenden BI-Landschaft, nicht aus einem neuen Silo
- Zugriffsrechte und Datenherkunft bleiben nachvollziehbar
Was ist Ad-hoc-Datenanalyse per natürlicher Sprache?
Ad-hoc-Datenanalyse per natürlicher Sprache ist ein Zugang zu Ihren vorhandenen strukturierten Unternehmensdaten, bei dem eine Frage in Alltagssprache in eine Datenbankabfrage übersetzt und das Ergebnis als Tabelle, Kennzahl oder Diagramm zurückgegeben wird. Die Vertriebsleitung fragt nach der Margenentwicklung einer Region, die Produktionsleitung nach Ausschussquoten je Linie. Fachlich geht es nicht um Dokumente oder Freitexte, sondern um Zahlen aus Datenbanken, Data Warehouse und Berichtssystemen.
Damit aus einer Frage eine belastbare Antwort wird, braucht es mehr als ein Sprachmodell: ein sauberes Datenmodell, eine verbindliche Begriffsdefinition und ein Berechtigungskonzept, das jede Abfrage auf das beschränkt, was die fragende Person sehen darf.
Weiterlesen
Wie funktioniert Ad-hoc-Datenanalyse per natürlicher Sprache im Alltag?
Ad-hoc-Datenanalyse per natürlicher Sprache läuft in vier Schritten ab: Eine Person stellt eine Frage in normaler Sprache, das System ordnet die Begriffe der Frage bekannten Kennzahlen und Dimensionen zu, daraus entsteht eine Abfrage an die Datenbank, und das Ergebnis kommt als Tabelle, Zahl oder Diagramm zurück. Bei Mehrdeutigkeit fragt das System nach, statt zu raten.
Ein Beispiel aus dem Vertrieb: Die Frage lautet, wie sich der Umsatz in Norddeutschland im letzten Quartal gegenüber dem Vorquartal entwickelt hat. Das System erkennt „Umsatz“, „Norddeutschland“ und „letztes Quartal“ als Begriffe, die es bereits kennt, weil sie in der zugrunde liegenden Begriffsdefinition hinterlegt sind. Es baut daraus eine Abfrage, holt die passenden Datensätze und liefert eine Grafik mit den beiden Zeiträumen im Vergleich.
Schwieriger wird es, wenn ein Begriff mehrere Bedeutungen zulässt. Die Frage nach dem „Ergebnis“ kann Rohertrag, Deckungsbeitrag oder Jahresüberschuss meinen. Ein sorgfältig eingerichtetes System für Ad-hoc-Datenanalyse per natürlicher Sprache stellt in diesem Fall eine Rückfrage, statt eine der Bedeutungen stillschweigend zu wählen. Diese Rückfrage ist kein Mangel, sondern der Punkt, an dem Fehlinterpretationen vermieden werden, bevor eine falsche Zahl in eine Entscheidung einfließt.
Am Ende steht immer ein nachvollziehbares Ergebnis: die verwendete Abfrage lässt sich einsehen, die Datenquelle ist benannt, und die Fachabteilung kann die Zahl gegen ihr eigenes Wissen prüfen, bevor sie damit weiterarbeitet.
Für wen lohnt sich Ad-hoc-Datenanalyse per natürlicher Sprache?
Ad-hoc-Datenanalyse per natürlicher Sprache lohnt sich für Rollen, die häufig wechselnde, spontane Fragen an Zahlen haben, aber selten selbst SQL schreiben: Vertriebsleitung, Controlling, Einkauf und Personalwesen. Der Nutzen ist hoch, wenn die zugrunde liegenden Daten bereits strukturiert und verknüpft vorliegen. Er ist gering, wenn jede Frage erst neue Datenquellen erschließen muss.
Die Vertriebsleitung fragt oft nach Umsatzentwicklung je Region oder Kunde und braucht die Antwort sofort, nicht erst nach Rücksprache mit dem Reporting. Das Controlling nutzt die sprachbasierte Abfrage, um Abweichungen im Monatsabschluss selbst zu untersuchen, bevor ein Bericht formuliert wird. Der Einkauf fragt nach Lieferantenpreisen oder Bestellmengen über mehrere Perioden, während die Produktion Stillstandszeiten oder Ausschussquoten je Linie abfragt.
Im Personalwesen ist Zurückhaltung angebracht: Fragen zu Gehalt, Krankheitstagen oder Leistungsbeurteilung berühren besonders schützenswerte Daten. Hier muss vorab geklärt sein, wer welche Felder überhaupt sehen darf, bevor eine Sprachabfrage eingerichtet wird. Ein Berechtigungskonzept, wie es die interne Berechtigungskonzept beschreibt, ist in solchen Fällen keine Kür, sondern Voraussetzung.
Wenig geeignet ist die Methode dort, wo Fragen selten sind, sich Datenquellen laufend ändern oder eine einzelne komplexe Kennzahl ohnehin nur eine Fachperson korrekt berechnen kann. Dann bleibt der klassische Bericht die verlässlichere Wahl.
Was ist Natural Language Query und was ist Text-to-SQL?
Natural Language Query bezeichnet die Fähigkeit, eine Frage in normaler Sprache zu stellen und eine Antwort in Form von Zahlen oder Grafiken zu erhalten. Text-to-SQL ist der technische Schritt dahinter: Die Frage wird in eine ausführbare Datenbankabfrage übersetzt. Beide Begriffe beschreiben also Anfang und Kern desselben Vorgangs, nicht zwei getrennte Werkzeuge.
Der Unterschied liegt in der Reichweite: Natural Language Query umfasst den gesamten Weg von der Eingabe bis zur verständlichen Ausgabe, während Text-to-SQL nur den mittleren Übersetzungsschritt betrifft. Ein System kann intern Text-to-SQL nutzen und trotzdem als Natural Language Query nach außen auftreten, weil es zusätzlich die Antwort wieder in Sprache oder Diagramm zurückübersetzt.
Ein verwandter, älterer Begriff ist das Natural Language Interface to Database, kurz NLIDB. Er stammt aus der Forschung zu Datenbankschnittstellen und meint im Kern dasselbe Prinzip, nur ohne den heutigen Bezug zu lernenden Sprachmodellen. Wer den Begriff in älterer Fachliteratur findet, kann ihn als Vorläufer der heutigen Ad-hoc-Datenanalyse per natürlicher Sprache einordnen.
Für die Praxis reicht es, sich zu merken: Die Frage stellt man in natürlicher Sprache, die Übersetzung in eine Datenbankabfrage geschieht im Hintergrund, und was am Ende zählt, ist die Verlässlichkeit der Antwort, nicht die Bezeichnung des dahinterliegenden Verfahrens.
Welche Rolle spielt die semantische Schicht?
Die semantische Schicht ist eine Zwischenebene, die festlegt, was Begriffe wie Umsatz, Deckungsbeitrag oder Region im Unternehmen genau bedeuten, unabhängig davon, aus welcher Datenquelle sie stammen. Sie bildet Anfragen auf diese vordefinierten Geschäftsbegriffe ab. Ohne sie würde jede Abfrage neu interpretieren müssen, was ein Wort meint, und dabei häufig etwas anderes berechnen, als die fragende Person erwartet.
Ein Beispiel macht den Unterschied deutlich: „Umsatz netto“ kann im Vertriebssystem den Rechnungsbetrag ohne Steuer meinen, im Controlling aber bereits um Rabatte und Retouren bereinigt sein. „Deckungsbeitrag“ wird in manchen Häusern auf Ebene der Produktgruppe berechnet, in anderen je Kunde. Und „Region“ folgt in einem System der Postleitzahl, in einem anderen der Vertriebsstruktur. Die semantische Schicht legt für jeden dieser Begriffe eine einzige verbindliche Definition fest, die alle Systeme verwenden.
Diese Vereinheitlichung ist der eigentliche Arbeitsaufwand hinter jeder Einführung von Ad-hoc-Datenanalyse per natürlicher Sprache. Die Sprachverarbeitung selbst ist inzwischen weitgehend ausgereifte Technik, die auf entsprechende Grundlagen aus der Verarbeitung natürlicher Sprache aufbaut. Die Frage, ob „Umsatz“ das eine oder das andere meint, lässt sich dagegen nur im Fachbereich klären, nicht durch ein Werkzeug allein.
Fehlt diese Schicht oder ist sie unvollständig gepflegt, entstehen scheinbar plausible, aber falsche Antworten: Zwei Personen fragen nach demselben Begriff und erhalten unterschiedliche Zahlen, ohne dass der Widerspruch auffällt. Deshalb gehört die Klärung der Begriffe an den Anfang jedes Projekts, nicht an dessen Ende.
Welche Voraussetzungen muss Ihre Datenbasis erfüllen?
Die Datenbasis muss vier Bedingungen erfüllen: Tabellen sind bereits sinnvoll miteinander verknüpft, Einheiten sind konsistent, Bezeichnungen sind gepflegt und Aktualisierungsstände sind bekannt. Zusätzlich müssen die in einer Frage verwendeten Begriffe möglichst genau der Terminologie entsprechen, die in der Datenbasis selbst hinterlegt ist.
Verknüpfte Tabellen bedeuten, dass Kundennummer, Auftragsnummer und Artikelnummer bereits zueinander in Beziehung gesetzt sind, bevor eine Frage gestellt wird. Ein System kann diese Beziehungen nicht zuverlässig selbst erraten, wenn sie in der Datenbank nicht hinterlegt sind. Konsistente Einheiten heißen, dass Mengenangaben durchgängig in derselben Einheit geführt werden, etwa Stück oder Kilogramm, und nicht je nach Abteilung wechseln.
Gepflegte Bezeichnungen sind Feldnamen und Kategorien, die verständlich und einheitlich benannt sind, statt als kryptische Kürzel aus einem historisch gewachsenen System zu erscheinen. Aktualisierungsstände müssen bekannt sein, damit eine Antwort auch angibt, auf welchem Datenstand sie beruht, statt einen veralteten Wert als aktuell auszugeben. Fehlt eine dieser vier Bedingungen für Ad-hoc-Datenanalyse per natürlicher Sprache, entstehen entweder Fehlermeldungen oder, schlimmer, plausibel wirkende, aber falsche Ergebnisse.
Wer prüfen will, wo die eigene Datenlandschaft steht, beginnt am besten mit einer technischen Bestandsaufnahme statt mit der Auswahl eines Werkzeugs. Vorarbeiten wie das strukturierte Aufbereiten und Verknüpfen von Datenquellen, wie sie im Bereich Data Engineering beschrieben sind, entscheiden meist stärker über den Erfolg als die spätere Sprachfunktion selbst.
Wie genau sind die Antworten von Text-to-SQL-Systemen?
Für operative, faktenbasierte Anfragen erreichen Text-to-SQL-Systeme in Untersuchungen Aufgabenerfolgsraten von etwa 80 bis 94 Prozent. Diese Spanne gilt nicht pauschal, sondern für Szenarien wie Lagerabfragen oder Vertriebskennzahlen, und sie hängt stark davon ab, wie sorgfältig die Datenbasis vorbereitet wurde und ob Fehlerkorrektur-Mechanismen eingebaut sind.
Die obere Grenze dieser Spanne wird typischerweise mit einem zweistufigen Vorgehen erreicht: Zunächst werden relevante Tabellen und Begriffe gezielt vorausgewählt, danach wird die eigentliche Abfrage erstellt. Ein zusätzlicher Nachschlagemechanismus prüft Ergebnisse gegen bekannte Werte und fängt so einen Teil der Fehler ab, bevor sie bei der fragenden Person ankommen. Ohne solche Absicherung liegt die Erfolgsquote eher am unteren Ende der Spanne.
Für die betriebliche Praxis bedeutet das zweierlei: Erstens ersetzt keine dieser Quoten die stichprobenartige Prüfung durch die Fachabteilung, gerade bei Zahlen, die in Entscheidungen einfließen. Zweitens steigt die Genauigkeit von Ad-hoc-Datenanalyse per natürlicher Sprache mit der Qualität der Vorarbeit an der Datenbasis, nicht allein mit der gewählten Technik. Eine gute Modellauswahl, wie sie im Bereich Modellentwicklung behandelt wird, kann diese Quote unterstützen, aber nicht ohne saubere Datengrundlage.
Deshalb wird bei jeder Einführung empfohlen, kritische Antworten stichprobenhaft gegenzuprüfen und die Fehlerquote über die Zeit zu beobachten, statt sich auf eine einmalige Testphase zu verlassen. Diese Kontrolle ist Teil des Betriebs, nicht ein einmaliger Abnahmeschritt.
Ersetzt Ad-hoc-Datenanalyse per natürlicher Sprache klassische Dashboards?
Nein. Standard-Reporting mit festen Kennzahlen und wiederkehrenden Ansichten deckt den überwiegenden Teil des betrieblichen Informationsbedarfs ab. Ad-hoc-Datenanalyse per natürlicher Sprache übernimmt den Rest: die spontane Zusatzfrage, die kein Dashboard vorgesehen hat, etwa eine Filterung nach einer ungewöhnlichen Kombination aus Region und Produktgruppe.
Dashboards bleiben deshalb die tragende Schicht. Sie zeigen etablierte Kennzahlen, sind geprüft und werden von Controlling oder Fachbereich gepflegt. Ein Sprachassistent ersetzt diese Struktur nicht, er liegt daneben und beantwortet Fragen, für die sonst ein Ticket an die Datenanalyse nötig wäre oder eine manuell gebaute Tabelle in einem Tabellenkalkulationsprogramm entsteht.
Das Verhältnis lässt sich als Ergänzung beschreiben: Ein fest definiertes Set an Kennzahlen bleibt die verlässliche Grundlage für Entscheidungen mit Tragweite, während die Sprachabfrage die Lücke zwischen zwei Reporting-Zyklen schließt. Wer zum Beispiel wissen will, warum ein bestimmter Monat vom Trend abweicht, muss dafür kein neues Dashboard beauftragen.
Für Unternehmen, die ihre bestehende Auswertung mit Verfahren des maschinellen Lernens erweitern wollen, bietet sich ein Blick auf verwandte Verfahren an, etwa auf die Datenanalyse mit maschinellem Lernen, die stärker auf Prognosen als auf Rückfragen zielt und damit ein anderes Bedürfnis abdeckt.
Wer darf welche Daten per Sprache abfragen?
Zugriff erhält, wer die Daten für seine Aufgabe tatsächlich benötigt. Ein Berechtigungskonzept nach dem Need-to-know-Prinzip legt für jede Rolle fest, welche Zeilen und Spalten sichtbar sind, bevor eine Sprachabfrage überhaupt gestellt wird. Der Assistent übernimmt dabei genau die Rechte, die im vorhandenen System bereits hinterlegt sind, er erweitert sie nicht.
In der Praxis bedeutet das Zeilenrechte, etwa wenn eine Vertriebsleitung nur die eigene Region sieht, und Spaltenrechte für einzelne Felder. Gehaltsdaten, Vertragskonditionen oder Gesundheitsangaben sind typische Beispiele, bei denen eine Sprachabfrage grundsätzlich blockiert wird, sofern die anfragende Person nicht ausdrücklich dazu berechtigt ist. Diese Sperre greift auf Datenbankebene, nicht erst in der Formulierung der Antwort.
Rechtlich verlangt Artikel 32 der Datenschutz-Grundverordnung technische und organisatorische Maßnahmen, die einen angemessenen Schutz personenbezogener Daten sicherstellen. Ein rollenbasiertes Berechtigungskonzept mit protokollierten Zugriffen ist eine solche Maßnahme und lässt sich für Ad-hoc-Datenanalyse per natürlicher Sprache aus der bestehenden Rechteverwaltung ableiten, statt sie neu zu entwerfen.
Wo ein Unternehmen noch keine ausreichend granulare Rechteverwaltung besitzt, empfiehlt sich vor der Einführung eine gezielte Bestandsaufnahme der vorhandenen Datenlage, damit sensible Felder von Beginn an korrekt behandelt werden.
Wie fügt sich Ad-hoc-Datenanalyse per natürlicher Sprache in Ihre BI-Landschaft ein?
Sie fügt sich als zusätzliche Schicht ein, nicht als Ersatz. Power BI, Qlik, Tableau, SAP Analytics Cloud und AWS QuickSight bringen bereits eigene Funktionen für natürlichsprachliche Abfragen mit oder lassen sich um eine solche Schnittstelle erweitern, sodass bestehende Datenmodelle, Berichte und Berechtigungen unverändert weiterverwendet werden.
Für die technische Entscheidung ist wichtig, dass die semantische Schicht des jeweiligen Werkzeugs die Grundlage bildet. Sie übersetzt Geschäftsbegriffe wie Umsatz, Deckungsbeitrag oder Kundengruppe in die konkreten Tabellen und Spalten der Datenbank. Fehlt diese Zuordnung, liefert auch die genaueste Ad-hoc-Datenanalyse per natürlicher Sprache falsche oder unvollständige Ergebnisse.
Die folgende Übersicht zeigt, welche Rolle die gängigen Werkzeuge dabei jeweils spielen und worauf bei einer Erweiterung zu achten ist.
ANCUD IT prüft in einer technischen Bestandsaufnahme, welches der vorhandenen Werkzeuge bereits eine Sprachfunktion mitbringt und wo eine zusätzliche Schnittstelle über eine Anbindung per Data Engineering sinnvoll ist, bevor über einen Neuaufbau überhaupt nachgedacht wird.
Wie verhindert man Fehlinterpretationen bei Datenabfragen in natürlicher Sprache?
Fehlinterpretationen werden verhindert, indem der Assistent bei Mehrdeutigkeit nachfragt, statt zu raten. Formulierungen wie „die letzten Monate“ oder „unsere größten Kunden“ lassen mehrere Lesarten zu. Der Agent legt dem Menschen die möglichen Auslegungen vor und lässt die endgültige Auswahl treffen, statt eine Annahme stillschweigend zu übernehmen.
Jede Antwort zeigt zusätzlich, welche Filter, Zeiträume und Quelltabellen tatsächlich verwendet wurden. Diese Transparenz erlaubt es der Fachabteilung, ein Ergebnis nachzuvollziehen, bevor es in eine Entscheidung einfließt. Eine Kennzahl ohne sichtbare Herkunft wird in keinem Anwendungsfall als belastbar behandelt.
Eine automatische Plausibilitätsprüfung vergleicht das Ergebnis mit typischen Wertebereichen und markiert Ausreißer, etwa einen Umsatz, der um ein Vielfaches über dem üblichen Monatswert liegt. Unvollständige Zeiträume, etwa ein laufender Monat, der noch nicht abgeschlossen ist, werden ausdrücklich gekennzeichnet, damit niemand einen Zwischenstand mit einem Endergebnis verwechselt.
Diese Kontrollmechanismen ersetzen keine fachliche Prüfung, sie machen sie erst möglich. Wer regelmäßig mit unstrukturierten Formulierungen arbeitet und Ad-hoc-Datenanalyse per natürlicher Sprache einführen will, findet in der Verarbeitung natürlicher Sprache Natural Language Processing die technische Grundlage, auf der auch diese Rückfragelogik aufbaut.
Welche Risiken hat Ad-hoc-Datenanalyse per natürlicher Sprache?
Das größte Risiko ist Scheinsicherheit: Eine flüssig formulierte Antwort wirkt überzeugender, als sie fachlich ist. Dagegen hilft die durchgängige Anzeige von Filtern, Quelltabellen und Zeiträumen, damit jede Zahl nachvollziehbar bleibt und niemand eine plausibel klingende Formulierung mit einem geprüften Ergebnis verwechselt.
Veraltete Datenstände sind ein zweites Risiko, etwa wenn eine nächtliche Aktualisierung noch nicht gelaufen ist. Ein sichtbarer Zeitstempel zum letzten Datenabgleich neben jeder Antwort macht diesen Zustand erkennbar, statt ihn zu verschweigen.
Uneinheitliche Begriffe zwischen Fachbereichen, etwa unterschiedliche Definitionen von „aktivem Kunden“ in Vertrieb und Marketing, führen zu widersprüchlichen Ergebnissen. Eine gepflegte semantische Schicht mit eindeutigen Geschäftsbegriffen pro Datenmodell reduziert dieses Risiko, ersetzt aber nicht die Abstimmung zwischen den Abteilungen selbst.
Lastspitzen auf Produktivsystemen entstehen, wenn viele gleichzeitige Anfragen der Ad-hoc-Datenanalyse per natürlicher Sprache direkt gegen die operative Datenbank laufen. Eine vorgelagerte Auswertungsschicht oder ein Replikat der Daten fängt diese Last ab, sodass das eigentliche Betriebssystem, etwa ein ERP, im Tagesgeschäft nicht beeinträchtigt wird.
Braucht man weiterhin Datenanalysten und Controlling?
Ja, ihre Rolle verschiebt sich, sie fällt nicht weg. Ein Sprachassistent für Ad-hoc-Datenanalyse per natürlicher Sprache beantwortet abgegrenzte Ad-hoc-Fragen zu vorhandenen Daten. Die Definitionshoheit über Kennzahlen, die Pflege des Datenmodells und komplexe, mehrstufige Analysen bleiben Aufgabe des Fachpersonals in Controlling und Datenanalyse.
Wer festlegt, was als „Umsatz“ oder „aktiver Kunde“ zählt, trifft weiterhin die Datenanalyse, nicht der Assistent. Diese Definitionen fließen in die semantische Schicht ein, auf der jede Sprachabfrage aufsetzt. Ohne diese Pflege liefert auch die beste Abfragetechnik uneinheitliche Ergebnisse.
Komplexe Fragestellungen, etwa mehrstufige Szenarienrechnungen oder die Ursachenanalyse hinter einer Kennzahlabweichung, bleiben Fachaufgabe. Der Assistent übernimmt die schnelle, wiederkehrende Zusatzfrage und schafft damit Zeit für genau diese anspruchsvolleren Analysen, statt sie zu ersetzen.
Wie läuft ein Pilotprojekt für Ad-hoc-Datenanalyse per natürlicher Sprache ab?
Ein Pilotprojekt beginnt mit einer Bestandsaufnahme des Datenmodells, gefolgt von der Auswahl eines einzelnen Fachbereichs, etwa Vertrieb oder Einkauf. Dort wird gemeinsam mit den Fachanwenderinnen und Fachanwendern ein Fragenkatalog aus tatsächlich gestellten Fragen erstellt. Anschließend läuft ein Testbetrieb mit echten Anfragen, dessen Trefferquote ausgewertet wird, bevor über eine Ausweitung entschieden wird.
Die Bestandsaufnahme prüft, ob Tabellen sinnvoll verknüpft sind, ob Kennzahlen einheitlich benannt sind und ob eine semantische Schicht vorhanden ist oder aufgebaut werden muss. Ohne diese Vorarbeit liefert jede Sprachabfrage nur zufällig richtige Ergebnisse, weil das System Begriffe nicht eindeutig auf Felder abbilden kann.
Die Wahl des Fachbereichs entscheidet über den Erfolg des gesamten Vorhabens. Sinnvoll ist ein Bereich mit klar abgegrenzten, wiederkehrenden Fragen und einem überschaubaren Datenbestand, etwa monatliche Vertriebskennzahlen statt unternehmensweiter Konzernberichte. Der Fragenkatalog wird mit den Personen erarbeitet, die später tatsächlich mit dem System arbeiten, nicht am Schreibtisch der IT-Abteilung.
Im Testbetrieb stellen ausgewählte Personen ihre echten Fragen, die Antworten werden protokolliert und mit den korrekten Werten verglichen. Aus dieser Auswertung ergibt sich, welche Fragetypen zuverlässig funktionieren und wo Nacharbeit am Datenmodell oder an der Formulierung nötig ist, etwa im Rahmen der Use-Case- und Datenevaluierung.
Wie messen Sie den Nutzen ohne erfundene Kennzahlen?
Der Nutzen von Ad-hoc-Datenanalyse per natürlicher Sprache wird an beobachtbaren Größen festgemacht, nicht an geschätzten Prozentsätzen: dem Anteil der Fragen, die ohne Rückfrage korrekt beantwortet werden, der Zahl der Ad-hoc-Anfragen, die noch beim Berichtswesen landen, und der Häufigkeit, mit der einmal erstellte Auswertungen wiederverwendet werden.
Die Trefferquote ohne Rückfrage zeigt, ob das Datenmodell und die Formulierungen der Fachabteilung zusammenpassen. Sinkt der Anteil der Anfragen, die noch per E-Mail oder Ticket an das Berichtswesen gehen, deutet das auf eine echte Entlastung hin, unabhängig von einem vorab versprochenen Wert.
Die Wiederverwendung von Auswertungen ist ein drittes Signal: Wird eine einmal gestellte Frage später erneut genutzt oder als Vorlage für ähnliche Fragen gespeichert, spricht das für Vertrauen in die Ergebnisse. Diese drei Größen werden über den Testbetrieb hinweg erhoben und dokumentiert, statt einen pauschalen Effizienzgewinn zu behaupten, der sich nicht belegen lässt.
Welche rechtlichen Rahmenbedingungen sind zu beachten?
Maßgeblich sind der Schutz personenbezogener Felder, eine lückenlose Protokollierung der Abfragen und die Einordnung nach dem EU AI Act. Ein reiner Auswertungsassistent für Ad-hoc-Datenanalyse per natürlicher Sprache ohne Profiling und ohne automatisierte Entscheidungen über Personen gilt in der Regel nicht als Hochrisiko-Anwendung, eine fallbezogene Prüfung bleibt aber notwendig.
Enthält die Datenbasis personenbezogene Felder, etwa Gehalts- oder Personaldaten, greift ein Berechtigungskonzept nach dem Need-to-know-Prinzip: Nur wer diese Daten fachlich benötigt, darf sie per Sprache abfragen. Technische und organisatorische Maßnahmen zum Zugriffsschutz sind dabei ohnehin verpflichtend, unabhängig davon, ob die Abfrage per Sprache oder klassisch per Dashboard erfolgt.
Jede Abfrage und jede Antwort wird protokolliert, damit im Zweifel nachvollziehbar bleibt, wer wann welche Daten gesehen hat. Diese Protokollierung ist zugleich die Grundlage, um Fehlinterpretationen des Systems zu erkennen und nachzubessern. Verstöße gegen die Vorgaben zum Umgang mit personenbezogenen Daten können Bußgelder nach sich ziehen, das ist aber ein Rahmen zur Einordnung des Risikos, keine Besonderheit der Sprachabfrage selbst.
Die konkrete Ausgestaltung von Berechtigungen und Protokollierung hängt von der bestehenden IT-Landschaft ab und wird im Rahmen der Data-Engineering-Beratung mit den vorhandenen Rollen- und Rechtekonzepten abgeglichen.
Was kostet Ad-hoc-Datenanalyse per natürlicher Sprache?
Die Kosten für Ad-hoc-Datenanalyse per natürlicher Sprache lassen sich ohne technische Bestandsaufnahme nicht seriös beziffern, sie hängen von fünf Faktoren ab: dem Zustand des Datenmodells, der Zahl der Quellsysteme, der bestehenden Lizenzlage, dem gewählten Betriebsmodell und dem Schulungsaufwand für die Fachabteilung. Diese Faktoren bestimmen Aufwand und Dauer stärker als die reine Softwareauswahl.
Ein gepflegtes, dokumentiertes Datenmodell mit wenigen Quellsystemen senkt den Aufwand deutlich gegenüber einer gewachsenen Landschaft mit mehreren SAP-Instanzen, Excel-Listen und Altsystemen. Ist bereits eine BI-Lösung wie Power BI oder SAP Analytics Cloud im Einsatz, prüft die Bestandsaufnahme, ob deren vorhandene Sprachfunktionen ausreichen oder eine zusätzliche semantische Schicht nötig ist.
Das Betriebsmodell, also ob Auswertungen in der bestehenden Cloud-Umgebung, on premises oder gemischt laufen, beeinflusst sowohl Lizenz- als auch Betriebskosten. Schulungsaufwand entsteht, weil Fachanwenderinnen und Fachanwender lernen müssen, wie Fragen zu formulieren sind, damit das System sie korrekt zuordnet.
Wie lange dauert die Einführung von Ad-hoc-Datenanalyse per natürlicher Sprache?
Eine belastbare Dauer für die Einführung von Ad-hoc-Datenanalyse per natürlicher Sprache lässt sich erst nach der Bestandsaufnahme nennen, da sie stark vom Zustand des Datenmodells abhängt. Realistisch ist ein Ablauf in drei Phasen: Bestandsaufnahme, Pilot in einem Fachbereich und schrittweise Ausweitung, wobei jede Phase von den Ergebnissen der vorherigen abhängt.
Die Bestandsaufnahme prüft Datenquellen, Berechtigungen und vorhandene BI-Werkzeuge. Erst danach lässt sich sagen, ob eine bestehende semantische Schicht genutzt werden kann oder neu aufgebaut werden muss, was die Dauer der Pilotphase maßgeblich bestimmt.
Der Pilot in einem Fachbereich umfasst Fragenkatalog, Testbetrieb und Auswertung der Trefferquote, wie im Abschnitt zum Pilotprojekt beschrieben. Erst wenn diese Phase belastbare Ergebnisse liefert, folgt die Ausweitung auf weitere Fachbereiche oder zusätzliche Datenquellen.
Abhängigkeiten liegen vor allem bei der Qualität bestehender Schnittstellen, der Verfügbarkeit von Ansprechpartnerinnen und Ansprechpartnern im Fachbereich und der Frage, ob zusätzliche Systeme wie ein Data-Warehouse angebunden werden müssen. Diese Punkte werden im Rahmen der technischen Bestandsaufnahme geklärt, bevor ein Zeitplan sinnvoll aufgestellt werden kann.
Wie starten Sie mit Ad-hoc-Datenanalyse per natürlicher Sprache?
Der erste Schritt ist eine technische Bestandsaufnahme der vorhandenen Datenquellen, gefolgt von einem Fragenkatalog aus dem betroffenen Fachbereich und einer Entscheidung über den Umfang des Pilotprojekts. Erst danach lässt sich beurteilen, welches Werkzeug und welcher Zeitrahmen realistisch sind.
Die Bestandsaufnahme klärt, welche Systeme angebunden werden sollen, wie das Datenmodell aufgebaut ist und welche Berechtigungen bereits bestehen. Parallel dazu sammelt der Fachbereich die Fragen, die im Alltag tatsächlich gestellt werden, statt hypothetischer Anwendungsfälle.
Auf dieser Grundlage wird der Pilotumfang für die Ad-hoc-Datenanalyse per natürlicher Sprache festgelegt: ein Fachbereich, eine begrenzte Zahl an Datenquellen und ein klar definierter Zeitraum für den Testbetrieb. So bleibt das Vorhaben überschaubar und die Ergebnisse lassen sich auswerten, bevor über eine Ausweitung entschieden wird. Mehr zu Vorgehen und Leistungen findet sich im Bereich Lösungen von ANCUD IT.
Was leistet der Sprachzugang zu Ihren Daten?
Sechs Funktionen, die den Unterschied zwischen einer netten Demonstration und einem belastbaren Arbeitsmittel ausmachen.
Der Einkauf fragt nach der Entwicklung der Materialkosten je Lieferant. Die Frage wird auf definierte Kennzahlen und Dimensionen abgebildet, nicht auf Tabellennamen geraten.
Zu jedem Ergebnis werden Zeitraum, Filter und Quellsystem angezeigt. So lässt sich prüfen, ob die Zahl das misst, was gemeint war.
Je nach Frage entsteht eine Kennzahl, eine Zeitreihe oder ein Vergleich nach Region. Die Darstellung folgt der Frage, nicht einem festen Berichtsraster.
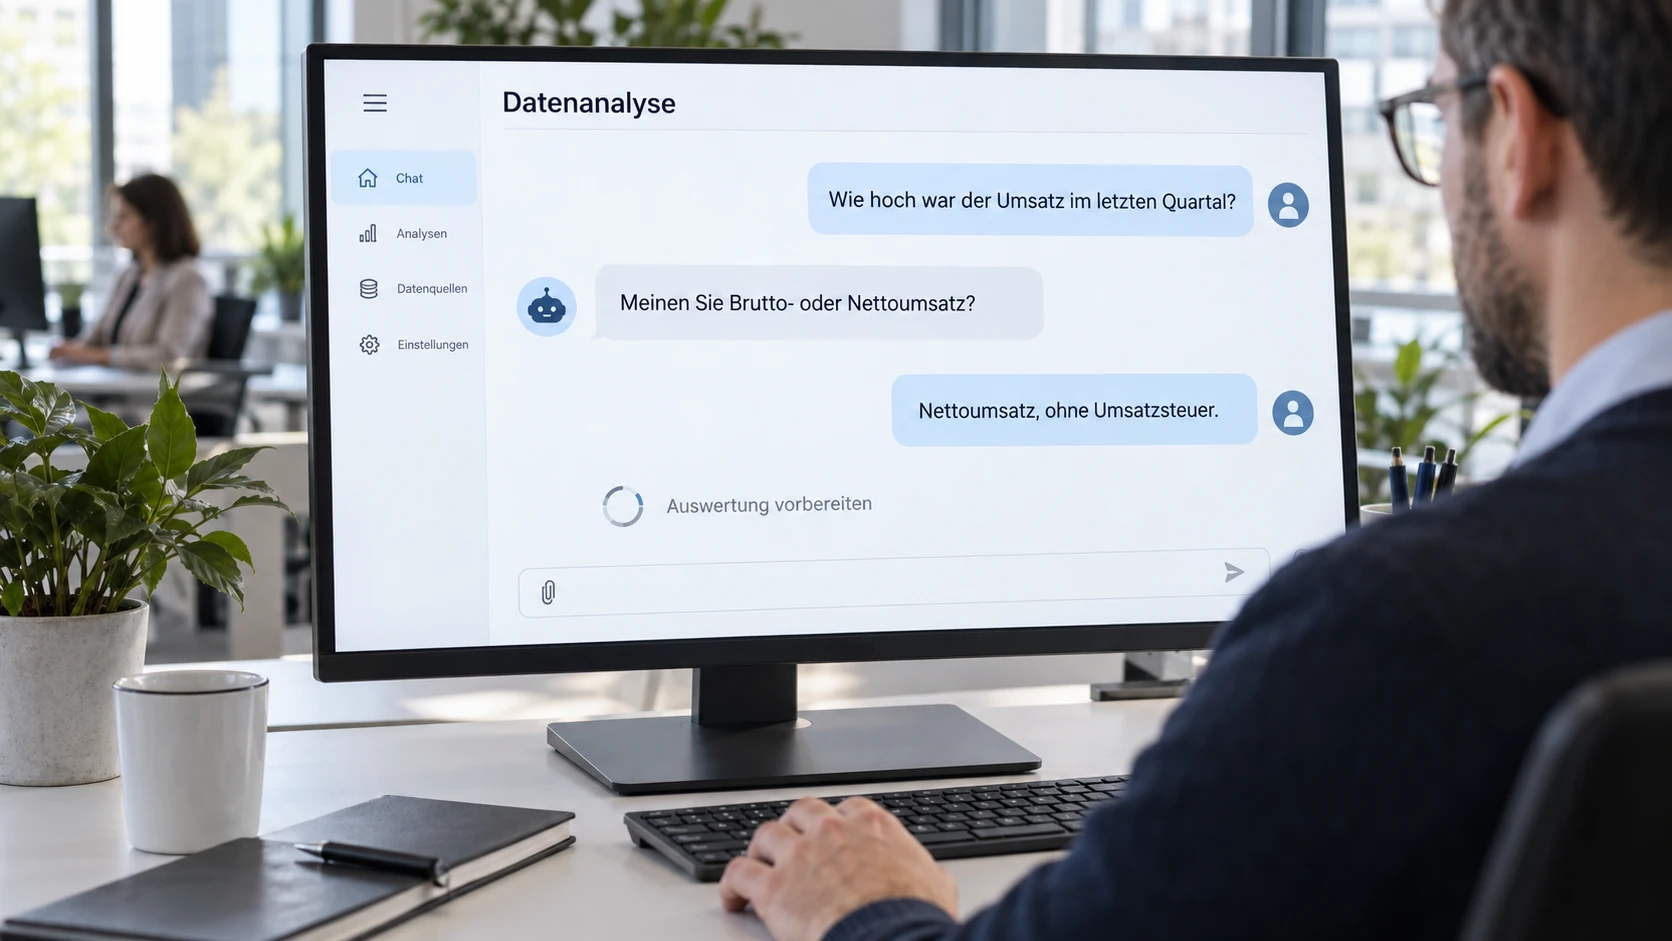
Ist unklar, ob Umsatz brutto oder netto gemeint ist, fragt das System nach, statt eine Variante stillschweigend zu wählen.
Die Abfrage läuft mit den Berechtigungen der fragenden Person. Wer keine Personaldaten sehen darf, erhält sie auch per Sprache nicht.
Eine bewährte Ad-hoc-Auswertung lässt sich als wiederkehrender Bericht festschreiben, statt jedes Mal neu formuliert zu werden.
Warum scheitern Sprachabfragen ohne gepflegtes Datenmodell?
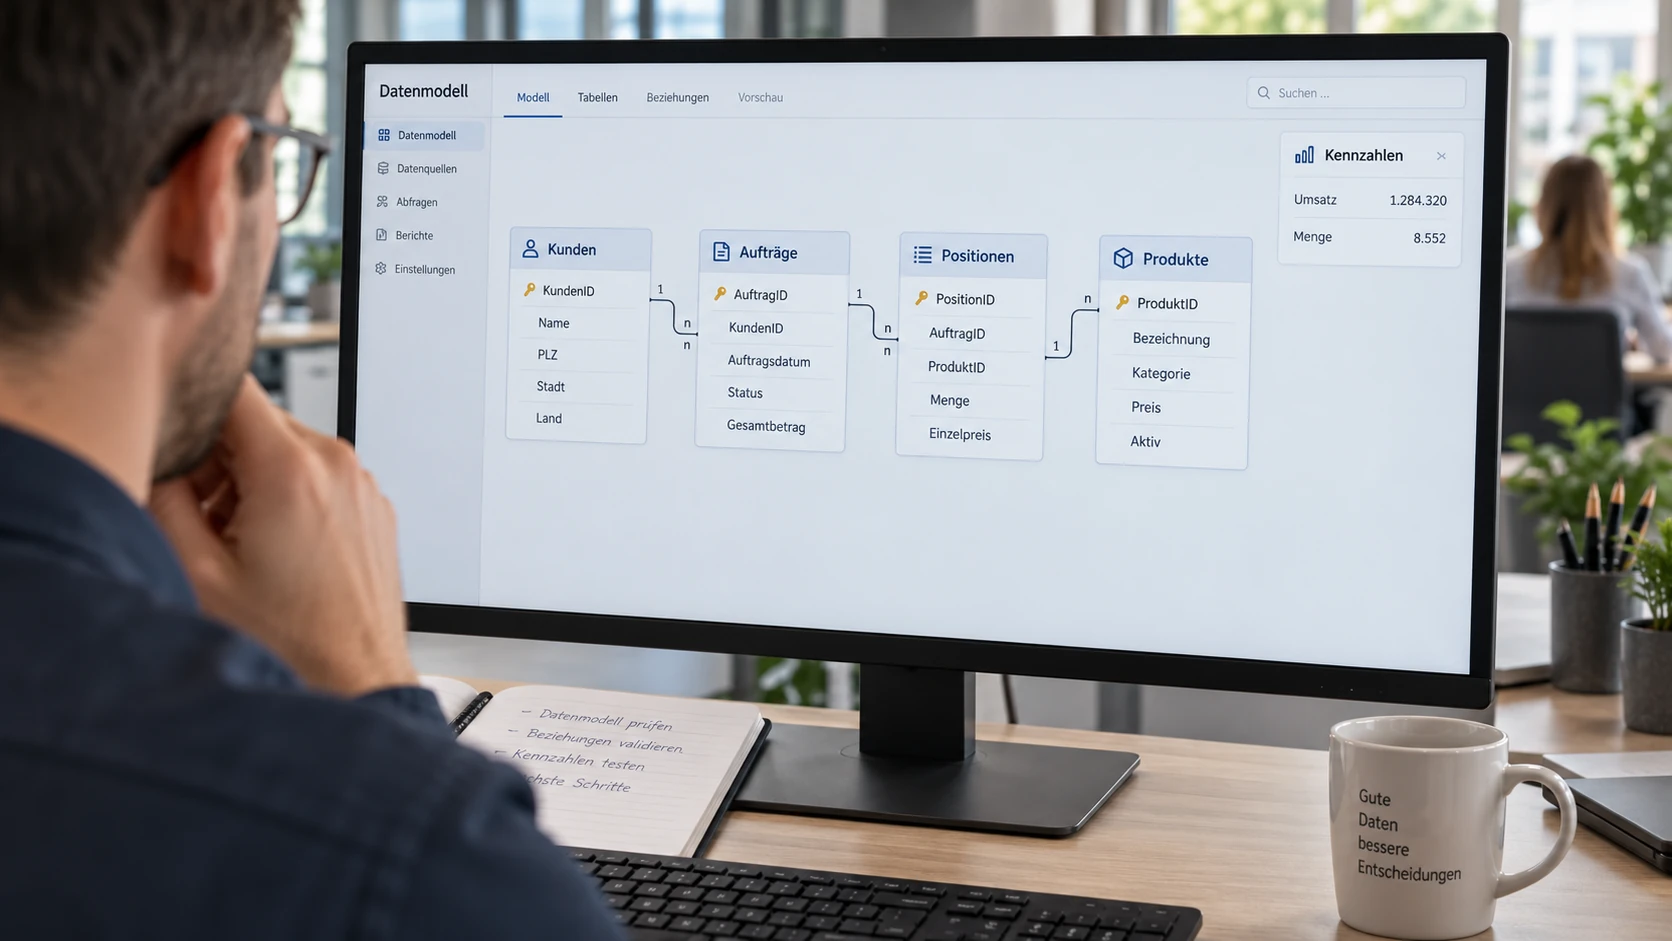
Die häufigste Ursache für falsche Antworten liegt nicht im Sprachmodell, sondern in der Datenbasis. Tabellen ohne Beziehung und uneinheitliche Bezeichnungen führen zu Ergebnissen, die plausibel aussehen und trotzdem falsch sind.
- Tabellen sind fachlich verknüpft, Schlüssel sind eindeutig
- Kennzahlen wie Deckungsbeitrag sind einmal verbindlich definiert
- Einheiten und Währungen sind über Quellen hinweg konsistent
- Regionen, Werke und Produktgruppen nutzen dieselben Bezeichnungen
- Der Aktualisierungsstand jeder Quelle ist sichtbar
Wie bleibt der Zugriff auf sensible Daten kontrolliert?
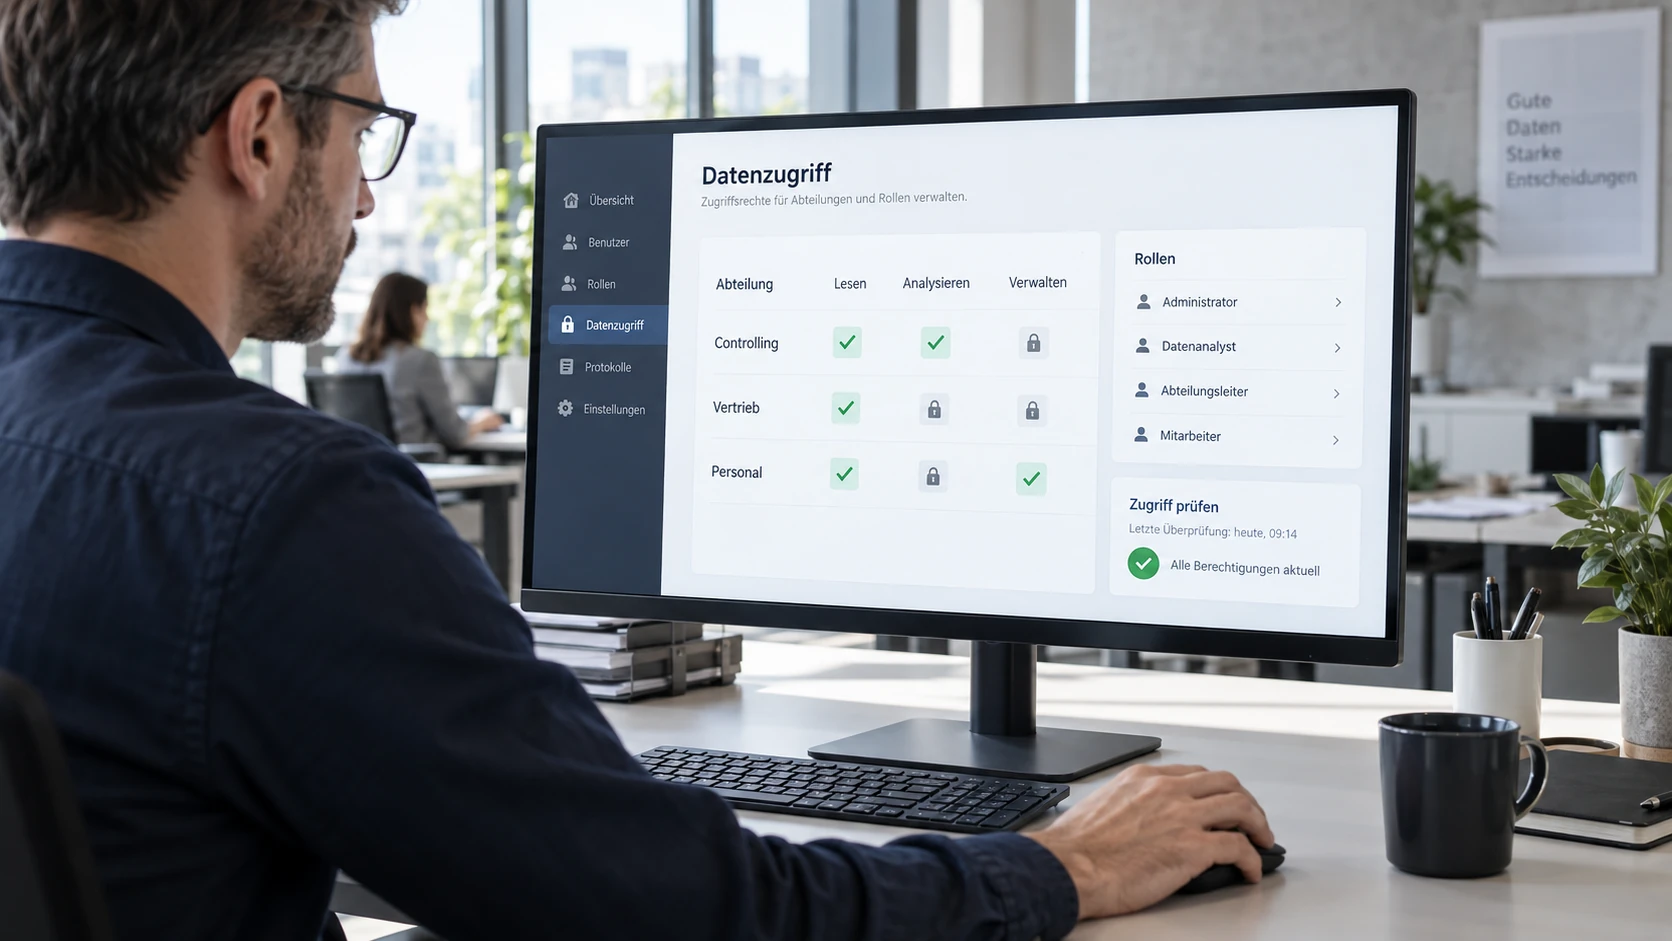
Ein Sprachzugang darf keine neue Tür in die Datenbank öffnen. Er nutzt die Rechte, die im Quellsystem bereits vergeben sind, und protokolliert jede Abfrage nachvollziehbar.
- Abfragen laufen mit der Identität der fragenden Person
- Zeilen- und Spaltenrechte gelten unverändert weiter
- Personalbezogene Felder sind gesondert freigegeben oder gesperrt
- Jede Abfrage wird mit Zeitpunkt und Ergebnisumfang protokolliert
- Auswertungen zum Abfrageverhalten prüfen Rechte regelmäßig nach
Wie ergänzt der Sprachzugang Ihr bestehendes Berichtswesen?
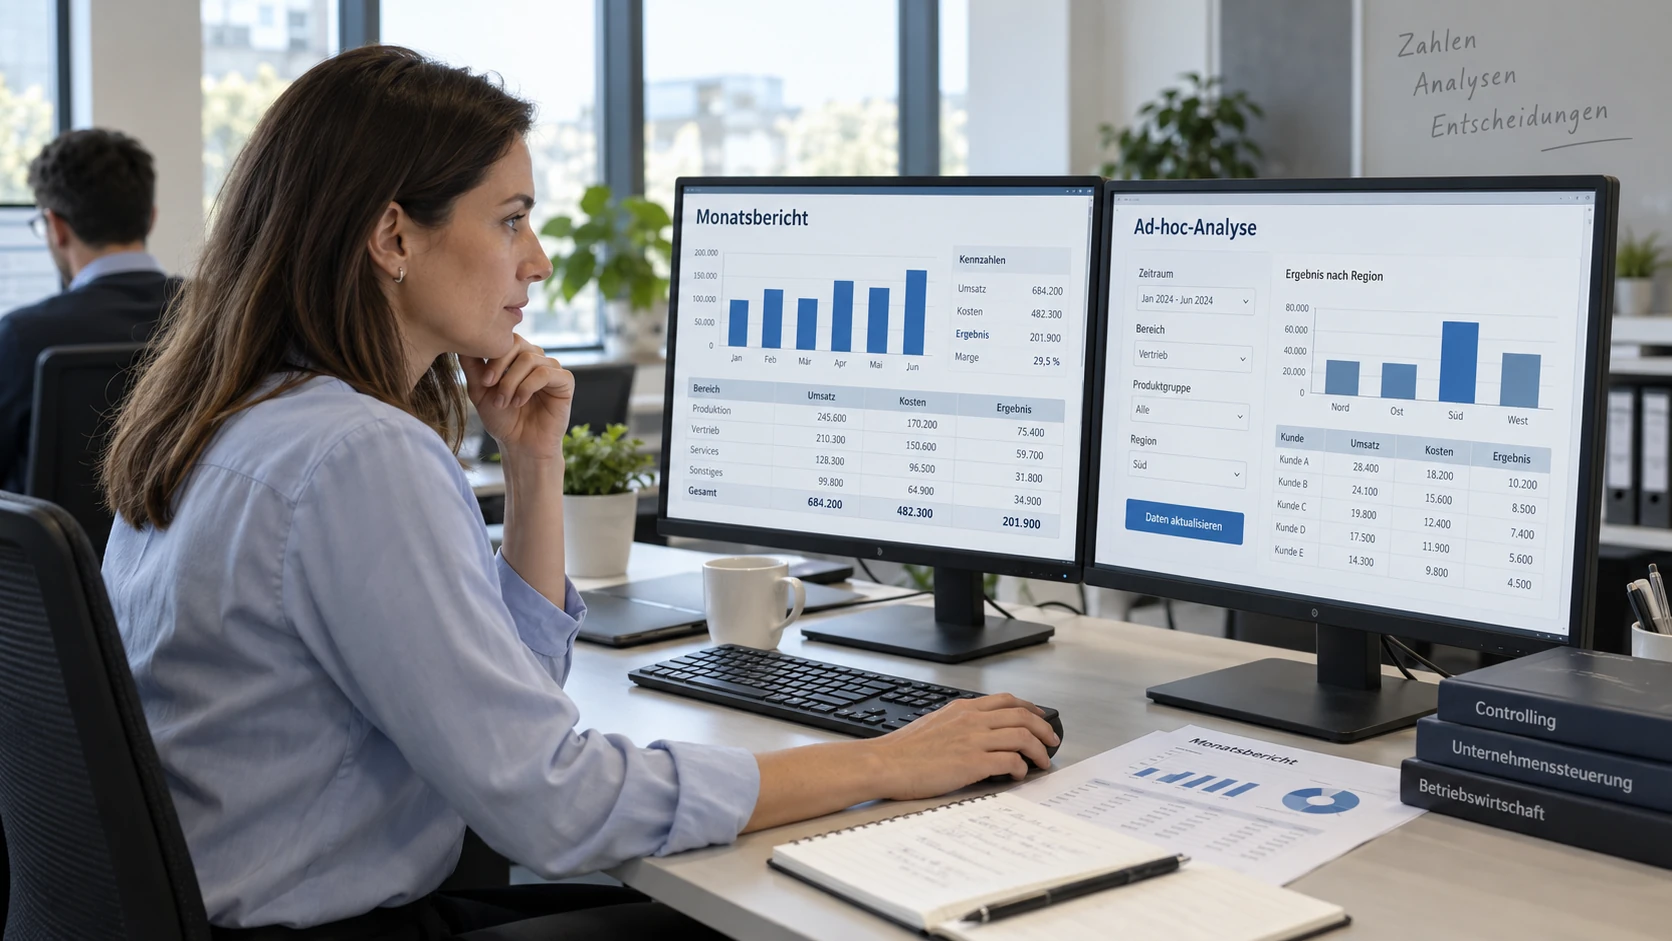
Standardberichte bleiben die Grundlage. Der Sprachzugang beantwortet die Fragen, die zwischen zwei Berichtsständen entstehen und für die sonst eine Anforderung an das Berichtswesen gestellt würde.
- Vorhandene Berichte und Kennzahlen bleiben unverändert gültig
- Ad-hoc-Fragen landen nicht mehr als Ticket im Berichtswesen
- Häufige Fragen werden in feste Berichte überführt
- Die Berichtslogik wird nicht doppelt gepflegt
- Fachbereiche arbeiten mit denselben Definitionen wie das Controlling
Was passiert bei mehrdeutigen oder unbeantwortbaren Fragen?
Nicht jede Frage lässt sich aus den vorhandenen Daten beantworten. Entscheidend ist, dass das System dies sagt, statt eine Zahl zu liefern, die niemand prüfen kann.
- Unklare Begriffe führen zu einer Rückfrage, nicht zu einer Annahme
- Fehlende Verknüpfungen werden als Grenze benannt
- Unvollständige Zeiträume werden gekennzeichnet
- Die verwendete Abfrage ist auf Wunsch einsehbar
- Auffällige Ergebnisse verweisen auf den zuständigen Fachkontakt
Wo wird Ad-hoc-Datenanalyse per natürlicher Sprache eingesetzt?
Drei typisierte Ausgangslagen aus dem Mittelstand. Keine echten Kundennamen, sondern Konstellationen, die uns regelmäßig begegnen.
Mittelständischer Maschinenbau
Margenfragen ohne Wartezeit- Herausforderung
- Die Vertriebsleitung will wissen, wie sich die Marge je Region und Produktgruppe entwickelt hat. Jede Sonderauswertung geht als Anforderung an das Controlling und wird dort von Hand aus zwei Systemen zusammengestellt.
- Lösung
- Die vorhandenen Kennzahlen aus Data Warehouse und Berichtssystem werden einmal verbindlich definiert. Danach stellen die Regionalverantwortlichen ihre Fragen selbst und erhalten Auswertung und Diagramm im gewohnten Werkzeug.
- Ergebnis
- Sonderauswertungen entstehen im Fachbereich selbst
- Marge wird überall nach derselben Definition gerechnet
- Das Controlling prüft Definitionen statt Einzelabfragen
Handelsunternehmen mit mehreren Standorten
Bestandsfragen direkt beantwortet- Herausforderung
- Die Filialsteuerung braucht kurzfristig Antworten zu Lagerreichweite und Abverkauf einzelner Artikelgruppen. Die Zahlen liegen im Warenwirtschaftssystem, abrufbar sind sie nur über feste Wochenberichte.
- Lösung
- Ein Sprachzugang wird auf das bestehende Berichtssystem gesetzt und auf die Artikel- und Standortdimensionen begrenzt. Rechte je Standort bleiben unverändert bestehen.
- Ergebnis
- Fragen zwischen zwei Berichtsständen sind beantwortbar
- Jede Filiale sieht nur ihre eigenen Bestände
- Häufige Fragen wurden in feste Berichte überführt
Energieversorger
Abweichungen früher sichtbar- Herausforderung
- Das Controlling erkennt Abweichungen zwischen Plan und Ist erst beim Monatsabschluss, weil Zwischenauswertungen aufwendig sind und nur von zwei Personen erstellt werden können.
- Lösung
- Plan- und Ist-Daten werden in einer gemeinsamen Begriffsebene zusammengeführt. Fachverantwortliche fragen Abweichungen je Kostenstelle und Zeitraum ab und erhalten die zugrunde liegenden Filter angezeigt.
- Ergebnis
- Abweichungen fallen vor dem Abschluss auf
- Die Herkunft jeder Zahl ist einsehbar
- Zwei Personen sind nicht mehr Engpass
Welche Grenzen sollten Sie vorher kennen?
Jedes der folgenden Risiken lässt sich beherrschen, wenn es vor der Einführung adressiert wird.
Ein Ergebnis sieht richtig aus, misst aber den falschen Zeitraum. Gegenmaßnahme: Zu jeder Antwort werden Filter, Zeitraum und Quelltabellen angezeigt, und Stichproben werden gegen den Standardbericht geprüft.
Vertrieb und Controlling rechnen Umsatz unterschiedlich. Gegenmaßnahme: Kennzahlen werden vor dem Start einmal verbindlich definiert und in der gemeinsamen Begriffsebene hinterlegt, bevor der Sprachzugang freigegeben wird.
Eine Frage würde Daten offenlegen, die der fragenden Person nicht zustehen. Gegenmaßnahme: Abfragen laufen mit deren Identität, sensible Felder sind gesperrt, jede Abfrage wird protokolliert.
Breit gestellte Fragen erzeugen aufwendige Abfragen. Gegenmaßnahme: Der Zugang arbeitet auf einer Auswertungsschicht mit Begrenzungen für Laufzeit und Ergebnismenge statt direkt auf dem operativen System.
Wie gehen wir bei der Einführung vor?
Sechs Schritte von der Bestandsaufnahme bis zum geregelten Betrieb. Der Umfang jedes Schritts richtet sich nach dem Zustand Ihrer Datenbasis.
Wir sehen uns Quellsysteme, Datenmodell, Berichtslandschaft und Berechtigungen an und halten fest, welche Fragen heute schon beantwortbar wären.
Die Fachabteilung sammelt die Fragen, die sie tatsächlich stellt. Dieser Katalog ist Maßstab für den Erfolg, nicht eine allgemeine Funktionsliste.
Umsatz, Marge, Region und Zeitraum werden gemeinsam mit dem Controlling definiert und in einer semantischen Schicht hinterlegt.
Ein Fachbereich arbeitet mit echten Fragen. Wir messen, welcher Anteil ohne Rückfrage korrekt beantwortet wird, und bessern gezielt nach.
Berechtigungen werden geprüft, die Protokollierung eingerichtet und die Freigabe für den produktiven Einsatz dokumentiert.
Weitere Bereiche kommen hinzu, häufige Fragen werden zu festen Berichten, und die Begriffsebene wird bei Änderungen am Datenmodell nachgeführt.
Wie können Sie mit uns zusammenarbeiten?
Vier Zuschnitte, je nachdem wie weit Ihre Datenbasis und Ihre Entscheidung sind.
Wir prüfen Datenmodell, Berichtslandschaft und Berechtigungen und sagen Ihnen, welche Fragen heute schon beantwortbar wären und welche Vorarbeit fehlt.
Bestandsaufnahme anfragenEin abgegrenzter Bereich, ein Fragenkatalog, ein Testbetrieb mit echten Fragen. Am Ende steht eine belastbare Aussage zur Trefferquote.
Pilot besprechenWir erweitern vorhandene Werkzeuge wie Power BI, Qlik oder SAP Analytics Cloud um einen Sprachzugang, statt eine zweite Berichtswelt aufzubauen.
Integration klärenWir führen die Begriffsebene bei Änderungen am Datenmodell nach, werten Fehlabfragen aus und halten die Antwortqualität über die Zeit stabil.
Betrieb anfragenPassende ANCUD-Lösungen
Häufige Fragen
Was ist Natural Language Query (NLQ)?
Natural Language Query bezeichnet die Abfrage von Daten in Alltagssprache. Die Frage wird auf definierte Kennzahlen und Dimensionen abgebildet, in eine Datenbankabfrage übersetzt und das Ergebnis als Zahl, Tabelle oder Diagramm zurückgegeben.
Wie genau sind die Antworten von Text-to-SQL-Systemen?
Eine Untersuchung von Text-to-SQL-Agenten in Unternehmensszenarien nennt bei operativen, faktenbasierten Anfragen Aufgabenerfolgsraten von 80 bis 94 Prozent. Diese Werte setzen ein gepflegtes Datenmodell und Mechanismen zur Fehlerkorrektur voraus, sie stellen sich nicht von selbst ein.
Ersetzt der Sprachzugang unsere Dashboards?
Nein. Ein gutes Standard-Reporting deckt nach Einschätzungen aus der Beratungspraxis über 80 Prozent des Informationsbedarfs ab. Der Sprachzugang beantwortet die zusätzlichen Fragen, die zwischen den festen Berichtsständen entstehen.
Wer darf welche Daten abfragen?
Jede Abfrage läuft mit der Identität der fragenden Person und den im Quellsystem vergebenen Zeilen- und Spaltenrechten. Sensible Felder wie Gehaltsdaten werden gesondert freigegeben oder gesperrt, jede Abfrage wird protokolliert.
Was kostet Ad-hoc-Datenanalyse per natürlicher Sprache?
Der Aufwand hängt vom Zustand des Datenmodells, der Zahl der Quellsysteme, der vorhandenen Lizenzlage und dem Betriebsmodell ab. Wir nennen einen Rahmen erst nach der technischen Bestandsaufnahme, vorher wäre jede Zahl geraten.
Brauchen wir weiterhin Datenanalysten?
Ja. Die Definitionshoheit über Kennzahlen, die Pflege des Datenmodells und komplexe Analysen bleiben beim Fachpersonal. Der Sprachzugang nimmt ihm die wiederkehrenden Einzelanfragen ab, nicht die fachliche Verantwortung.
Sagen Sie uns, welche Fragen Ihr Fachbereich heute nicht beantwortet bekommt. Wir prüfen, ob Ihre Datenbasis dafür schon trägt.
- Kurzer Blick auf Quellsysteme und Berichtslandschaft
- Einschätzung zur nötigen Vorarbeit
- Vorschlag für einen abgegrenzten Pilotbereich


